O rețea neuronală mică
Sistemul de diferențiere automată știe să calculeze gradienții oricărei expresii. O rețea neuronală este doar o expresie mai mare: sume ponderate, funcții de activare și, la final, o pierdere. Pe această pagină o construim din obiecte Value, în fișierul nn.py, și o antrenăm pe o problemă mică, în fișierul moons.py.
La redare, playerul se încarcă de pe YouTube (detalii).
Neuronul
Secțiune intitulată „Neuronul”Un neuron artificial are câte o pondere pentru fiecare intrare și un bias. Calculează suma ponderată a intrărilor, adaugă bias-ul și aplică funcția de activare.
class Module:    def parameters(self):        return []
    def zero_grad(self):        # Gradienții se adună la fiecare backward(), așa că îi readucem la zero înaintea fiecărui pas.        for p in self.parameters():            p.grad = 0.0

class Neuron(Module):    def __init__(self, nin, activation="tanh"):        # Ponderi aleatoare mici, câte una pentru fiecare intrare, și un bias care pornește de la zero.        self.w = [Value(random.uniform(-1, 1)) for _ in range(nin)]        self.b = Value(0.0)        self.activation = activation
    def __call__(self, x):        # Suma ponderată a intrărilor plus bias, apoi funcția de activare.        z = sum((wi * xi for wi, xi in zip(self.w, x)), self.b)        if self.activation == "tanh":            return z.tanh()        if self.activation == "relu":            return z.relu()        return z  # fără activare, pentru stratul de ieșire
    def parameters(self):        return self.w + [self.b]
Ponderile pornesc de la valori aleatoare între −1 și 1. Dacă ar porni toate de la aceeași valoare, neuronii unui strat ar calcula același lucru și ar primi aceiași gradienți, deci ar rămâne identici. Funcția sum primește bias-ul ca valoare de pornire, așa că rezultatul este un singur obiect Value, cu tot calculul în propriul graf.
Clasa de bază Module adaugă metoda zero_grad, care readuce gradienții la zero. Pe pagina despre diferențierea automată am văzut de ce este nevoie de această metodă: fiecare backward() adaugă la gradienții existenți.
Straturi și rețea
Secțiune intitulată „Straturi și rețea”Un strat este o listă de neuroni care primesc aceleași intrări. O rețea cu mai multe straturi (multilayer perceptron, MLP) este o listă de straturi, în care ieșirile unui strat devin intrările stratului următor.
class Layer(Module):    def __init__(self, nin, nout, activation="tanh"):        self.neurons = [Neuron(nin, activation) for _ in range(nout)]
    def __call__(self, x):        # Toți neuronii stratului primesc aceleași intrări.        out = [n(x) for n in self.neurons]        return out[0] if len(out) == 1 else out
    def parameters(self):        return [p for n in self.neurons for p in n.parameters()]

class MLP(Module):    def __init__(self, nin, nouts, activation="tanh"):        # De exemplu, MLP(2, [16, 16, 1]): 2 intrări, două straturi ascunse de câte 16 neuroni și o ieșire.        sizes = [nin] + nouts        self.layers = [            Layer(sizes[i], sizes[i + 1], activation if i < len(nouts) - 1 else "linear")            for i in range(len(nouts))        ]
    def __call__(self, x):        # Propagarea directă: ieșirile fiecărui strat devin intrările stratului următor.        for layer in self.layers:            x = layer(x)        return x
    def parameters(self):        return [p for layer in self.layers for p in layer.parameters()]
Straturile ascunse au funcția de activare aleasă, implicit tanh, iar ultimul strat nu are activare, ca ieșirea să poată lua orice valoare. Metoda parameters adună ponderile și bias-urile tuturor neuronilor, pentru că pe acestea le va modifica antrenarea.
Rețeaua folosită mai jos are 2 intrări, două straturi ascunse de câte 8 neuroni și o ieșire. Fiecare neuron are câte o pondere pentru fiecare intrare și un bias, deci rețeaua are 105 parametri.
import randomfrom nn import MLP
random.seed(1)model = MLP(2, [8, 8, 1])for i, layer in enumerate(model.layers, start=1):  n_in = len(layer.neurons[0].w)  print(f"stratul {i}: {len(layer.neurons)} × ({n_in} ponderi + 1 bias) = {len(layer.parameters())} parametri")print("în total:", len(model.parameters()))print()print("ieșirea pentru intrarea [1.0, -0.5]:", model([1.0, -0.5]))
Codul poate fi modificat și rulat direct în browser (Ctrl + Enter).
Datele: două semilune
Secțiune intitulată „Datele: două semilune”Problema este una de clasificare (classification): punctele din plan aparțin uneia din două clase, iar rețeaua trebuie să spună, pentru fiecare punct, clasa din care face parte. Punctele sunt așezate pe două semilune întrepătrunse, așa că nicio linie dreaptă nu le poate separa. Rețeaua are nevoie de straturi ascunse neliniare.
def make_moons(n, noise=0.1, seed=0): # Două semilune întrepătrunse: punctele de pe semiluna de sus au eticheta +1, cele de jos, -1. rng = random.Random(seed) points, labels = [], [] for i in range(n): t = math.pi * rng.random() if i % 2 == 0: x, y, label = math.cos(t), math.sin(t), 1.0 else: x, y, label = 1 - math.cos(t), 0.5 - math.sin(t), -1.0 points.append([x + rng.gauss(0, noise), y + rng.gauss(0, noise)]) labels.append(label) return points, labelsPunctele de pe semiluna de sus au eticheta +1, iar cele de pe semiluna de jos, −1. Zgomotul gaussian, cu deviația standard 0,1, le împrăștie puțin în jurul curbelor, ca problema să semene cu datele reale.
from moons import make_moons
points, labels = make_moons(100)for p, y in zip(points[:6], labels[:6]):  print(f"punctul ({p[0]:+.2f}, {p[1]:+.2f}) are eticheta {y:+.0f}")print("puncte cu eticheta +1:", sum(y > 0 for y in labels), "din", len(labels))
Codul poate fi modificat și rulat direct în browser (Ctrl + Enter).
Pierderea și acuratețea
Secțiune intitulată „Pierderea și acuratețea”Ieșirea rețelei este un număr, numit scor. Vrem un scor apropiat de +1 pentru semiluna de sus și de −1 pentru cea de jos. Pierderea măsoară cât de departe sunt scorurile de aceste ținte, prin eroarea pătratică medie (mean squared error): diferența dintre scor și etichetă, ridicată la pătrat, apoi mediată pe toate punctele. Clasa prezisă este dată de semnul scorului, iar acuratețea (accuracy) este proporția de puncte clasificate corect.
Pentru curioșiEroarea pătratică medie
Pentru puncte, cu scorurile și etichetele , pierderea este:
def loss_and_accuracy(model, points, labels): scores = [model(p) for p in points] # Eroarea pătratică medie: scorul rețelei ar trebui să fie +1 pentru o clasă și -1 pentru cealaltă. loss = sum((s - y) ** 2 for s, y in zip(scores, labels)) / len(labels) # Clasa prezisă este semnul scorului. correct = sum((s.data > 0) == (y > 0) for s, y in zip(scores, labels)) return loss, correct / len(labels)Pierderea este un singur obiect Value, calculat din scorurile tuturor celor 100 de puncte. Graful pierderii conține deci toate calculele rețelei, pentru toate punctele, iar un singur backward() dă gradientul pierderii în raport cu fiecare dintre cei 105 parametri.
Antrenarea
Secțiune intitulată „Antrenarea”Antrenarea repetă același pas de mai multe ori.
def train(model, points, labels, steps=100, lr=0.1, log_every=10): for step in range(steps): # 1. Propagarea directă și pierderea, pe toate punctele odată. loss, accuracy = loss_and_accuracy(model, points, labels) # 2. Gradienții vechi se șterg, apoi retropropagarea calculează gradienții noi. model.zero_grad() loss.backward() # 3. Coborârea pe gradient: fiecare parametru face un pas mic în sensul în care pierderea scade. for p in model.parameters(): p.data -= lr * p.grad if step % log_every == 0 or step == steps - 1: print(f"pasul {step:3d} pierdere {loss.data:.4f} acuratețe {accuracy:.0%}")- Propagarea directă: rețeaua calculează scorurile tuturor punctelor, iar din scoruri se calculează pierderea.
- Ștergerea gradienților:
zero_grad()readuce la zero gradienții de la pasul anterior. - Retropropagarea:
loss.backward()calculează gradientul pierderii în raport cu fiecare parametru. - Actualizarea: fiecare parametru face un pas mic în sens opus gradientului său, adică în sensul în care pierderea scade. Mărimea pasului este dată de rata de învățare,
lr = 0.1.
Pasul 4 este coborârea pe gradient, scrisă direct, fără un optimizator. Aici se modifică p.data, nu p: parametrul rămâne același obiect, iar rețeaua îl va folosi, cu noua valoare, la următoarea propagare directă.
Exemplul de mai jos rulează în browser primii 30 de pași ai antrenării. Durează câteva secunde, pentru că fiecare pas construiește și parcurge un graf cu zeci de mii de noduri.
import randomfrom moons import make_moons, trainfrom nn import MLP
random.seed(1)points, labels = make_moons(100)model = MLP(2, [8, 8, 1])train(model, points, labels, steps=30, lr=0.1, log_every=5)
Codul poate fi modificat și rulat direct în browser (Ctrl + Enter).
La început, rețeaua clasifică greșit majoritatea punctelor, iar pierderea este mare, pentru că ponderile aleatoare dau scoruri departe de ±1. După câțiva pași, scorurile ajung în jurul țintelor, iar acuratețea trece de 85%.
Rularea locală
Secțiune intitulată „Rularea locală”Pe calculatorul local, antrenarea completă, de 200 de pași, se pornește cu o singură comandă.
python moons.pyPe un laptop modern, antrenarea a durat circa 30 de secunde. Rezultatul arată astfel.
Puncte: 100, parametri: 105pasul 0 pierdere 3.5031 acuratețe 19%pasul 20 pierdere 0.3162 acuratețe 88%pasul 40 pierdere 0.2869 acuratețe 89%pasul 60 pierdere 0.2495 acuratețe 92%pasul 80 pierdere 0.2030 acuratețe 94%pasul 100 pierdere 0.1569 acuratețe 96%pasul 120 pierdere 0.1227 acuratețe 96%pasul 140 pierdere 0.1034 acuratețe 97%pasul 160 pierdere 0.0934 acuratețe 98%pasul 180 pierdere 0.0876 acuratețe 98%pasul 199 pierdere 0.0836 acuratețe 98%Durata antrenării: 30.8 sFrontiera de decizie a fost salvată în imagini/frontiera.svgLa final, scriptul calculează scorul rețelei pe o grilă de puncte și desenează, cu Matplotlib, frontiera de decizie (decision boundary), adică linia pe care scorul trece prin zero. Rețeaua a învățat o curbă care urmează forma celor două semilune.
def save_boundary(model, points, labels, path, resolution=80):    import matplotlib
    matplotlib.use("Agg")    import matplotlib.pyplot as plt
    # Scorul rețelei pe o grilă de puncte, fără gradienți: ne interesează doar valorile.    xs = [-1.5 + 4.0 * i / (resolution - 1) for i in range(resolution)]    ys = [-1.2 + 2.9 * j / (resolution - 1) for j in range(resolution)]    grid = [[model([x, y]).data for x in xs] for y in ys]
    fig, ax = plt.subplots(figsize=(6, 4))    ax.contourf(xs, ys, grid, levels=[-100, 0, 100], colors=["#e8833a", "#3d6fd9"], alpha=0.25)    ax.contour(xs, ys, grid, levels=[0], colors=["#888888"], linewidths=1)    for label, color in [(1.0, "#3d6fd9"), (-1.0, "#e8833a")]:        sel = [p for p, y in zip(points, labels) if y == label]        ax.scatter([p[0] for p in sel], [p[1] for p in sel], s=16, color=color, edgecolors="none")    ax.set_axis_off()    fig.savefig(path, bbox_inches="tight", transparent=True)    plt.close(fig)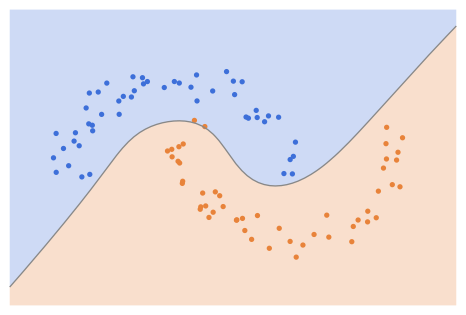
Câteva puncte, aflate chiar în zona în care semilunile se apropie, rămân de partea greșită. Cu mai mulți pași de antrenare, rețeaua le-ar putea învăța și pe acestea, dar ar risca să urmeze zgomotul, nu forma semilunilor. Pentru a ști cât de bine generalizează, am avea nevoie de un set de testare separat, ca pe pagina următoare.
Limita unui sistem pentru scalari
Secțiune intitulată „Limita unui sistem pentru scalari”Sistemul nostru este ușor de urmărit, dar lent. Fiecare număr este un obiect Python, iar fiecare operație creează un obiect nou și o funcție nouă. Rețeaua cu 105 parametri, pe 100 de puncte, a avut nevoie de circa 30 de secunde pentru 200 de pași.
Rețeaua pentru cifrele MNIST, de pe pagina următoare, are 101.770 de parametri. Exemplul de mai jos construiește această rețea din obiecte Value și măsoară o singură propagare directă și retropropagare, pentru o singură imagine, aici cu pixeli aleatori.
import randomimport timefrom nn import MLP
random.seed(0)model = MLP(784, [128, 10], activation="relu")print("parametri:", len(model.parameters()))
image = [random.random() for _ in range(784)]start = time.time()scores = model(image)loss = sum((s - (1.0 if i == 3 else 0.0)) ** 2 for i, s in enumerate(scores))model.zero_grad()loss.backward()print(f"o imagine: {time.time() - start:.1f} s")
Codul poate fi modificat și rulat direct în browser (Ctrl + Enter).
Pe un laptop modern, o singură imagine durează în jur de o secundă, atât local, cât și în browser. Setul de antrenare MNIST are 60.000 de imagini, așa că o singură trecere prin toate imaginile ar dura cel puțin 16 ore. Pe pagina următoare, aceeași rețea, scrisă cu matrice NumPy, face o trecere completă în mai puțin de o secundă.
Bibliografie
Secțiune intitulată „Bibliografie”- Karpathy, A. (2020). micrograd. Cod sursă, GitHub.
- Rosenblatt, F. (1958). The perceptron: A probabilistic model for information storage and organization in the brain. Psychological Review, 65(6), 386–408.
- Rumelhart, D. E., Hinton, G. E. și Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323(6088), 533–536.
Cookie-uri
Site-ul folosește Google Analytics pentru statistici de trafic. Cookie-urile de analiză se activează doar după acceptare. Detalii în politica de cookie-uri.