Cifrele MNIST cu NumPy și PyTorch
Pe pagina anterioară, sistemul pentru scalari a avut nevoie de circa o secundă pentru o singură imagine. Rețeaua rămâne aceeași, dar calculul se poate organiza altfel: toate sumele ponderate ale unui strat, pentru un lot întreg de imagini, sunt un singur produs de matrice. Pe această pagină scriem rețeaua cu NumPy, o librărie Python pentru calcul cu matrice, și scriem de mână, pentru matrice, aceleași derivate pe care sistemul le aplica număr cu număr.
La redare, playerul se încarcă de pe YouTube (detalii).
Setul de date MNIST
Secțiune intitulată „Setul de date MNIST”MNIST este un set de 70.000 de cifre scrise de mână, publicat în 1998 de Yann LeCun, Léon Bottou, Yoshua Bengio și Patrick Haffner. Cifrele vin din două colecții ale institutului american NIST, scrise de angajați ai Biroului de Recensământ și de elevi de liceu. Fiecare imagine are 28 × 28 pixeli în tonuri de gri, cu cifra centrată. Setul este împărțit în 60.000 de imagini de antrenare și 10.000 de imagini de testare, scrise de alte persoane decât cele din setul de antrenare.
Fișierul mnist_data.py descarcă setul o singură dată, în copia publicată de echipa Keras, de 11 MB, și verifică amprenta SHA-256 a fișierului.
URL = "https://storage.googleapis.com/tensorflow/tf-keras-datasets/mnist.npz"

SHA256 = "731c5ac602752760c8e48fbffcf8c3b850d9dc2a2aedcf2cc48468fc17b673d1"

def download(path="data/mnist.npz"):    if not os.path.exists(path):        os.makedirs(os.path.dirname(path), exist_ok=True)        print(f"Descărcăm {URL}")        urllib.request.urlretrieve(URL, path)    # Amprenta SHA-256 confirmă că fișierul este complet și neschimbat.    with open(path, "rb") as f:        digest = hashlib.sha256(f.read()).hexdigest()    if digest != SHA256:        raise RuntimeError(f"{path} nu are amprenta așteptată. Ștergeți fișierul și rulați din nou.")    return path

def load_mnist(path="data/mnist.npz"):    with np.load(download(path)) as f:        x_train, y_train = f["x_train"], f["y_train"]        x_test, y_test = f["x_test"], f["y_test"]    # Fiecare imagine devine un vector de 784 de numere între 0 și 1, iar etichetele, numere întregi de la 0 la 9.    x_train = x_train.reshape(-1, 784).astype(np.float32) / 255    x_test = x_test.reshape(-1, 784).astype(np.float32) / 255    return x_train, y_train.astype(np.int64), x_test, y_test.astype(np.int64)
Fiecare imagine devine un vector de 784 de numere (28 × 28), iar fiecare pixel, un număr între 0 și 1. Rețeaua nu știe că pixelii formau o imagine: pentru rețea, o cifră este doar o listă de 784 de intrări.
De la numere la matrice
Secțiune intitulată „De la numere la matrice”Un strat cu 128 de neuroni are, pentru fiecare neuron, câte o pondere pentru fiecare dintre cele 784 de intrări. Toate aceste ponderi formează o matrice , cu 784 de rânduri și 128 de coloane: coloana conține ponderile neuronului . Dacă așezăm și imaginile unui lot pe rândurile unei matrice , produsul conține, pe rândul fiecărei imagini, sumele ponderate ale tuturor celor 128 de neuroni.
Pentru curioșiUn strat ca produs de matrice
Pentru un lot de imagini, cu de forma , de forma și vectorul de bias cu 128 de elemente:
Elementul este exact suma ponderată calculată de Neuron pentru imaginea și neuronul . Bias-ul se adaugă fiecărui rând.
Exemplul de mai jos calculează o singură sumă ponderată în ambele feluri, cu o sumă în Python, ca sistemul pentru scalari, și din produsul de matrice.
import numpy as npfrom mnist_numpy import init_params
params = init_params()rng = np.random.default_rng(0)x = rng.random((5, 784)).astype(np.float32)  # 5 „imagini”, cu pixeli aleatori
# Neuronul 0 al stratului ascuns, pentru prima imagine, ca în sistemul pentru scalari.z = params["b1"][0] + sum(params["W1"][k, 0] * x[0, k] for k in range(784))print("o sumă în Python:      ", z)
# Toți neuronii, pentru toate imaginile, dintr-un singur produs de matrice.z1 = x @ params["W1"] + params["b1"]print("din produsul de matrice:", z1[0, 0])print("forma rezultatului:", z1.shape)
Codul poate fi modificat și rulat direct în browser (Ctrl + Enter).
Cele două numere coincid. Produsul de matrice face însă dintr-odată 5 × 128 de astfel de sume, cu cod compilat și optimizat, nu cu obiecte Python.
Propagarea directă
Secțiune intitulată „Propagarea directă”Rețeaua are 784 de intrări, un strat ascuns de 128 de neuroni cu activare ReLU și un strat de ieșire cu 10 neuroni, câte unul pentru fiecare cifră. Are deci 784 × 128 + 128 + 128 × 10 + 10 = 101.770 de parametri.
def init_params(n_in=784, n_hidden=128, n_out=10, seed=0):    rng = np.random.default_rng(seed)    # Inițializarea He: ponderi normale cu varianța 2 / numărul de intrări, potrivită pentru ReLU.    return {        "W1": (rng.standard_normal((n_in, n_hidden)) * np.sqrt(2 / n_in)).astype(np.float32),        "b1": np.zeros(n_hidden, dtype=np.float32),        "W2": (rng.standard_normal((n_hidden, n_out)) * np.sqrt(2 / n_hidden)).astype(np.float32),        "b2": np.zeros(n_out, dtype=np.float32),    }

def forward(params, x):    # x are câte un rând pentru fiecare imagine din lot: forma (lot, 784).    z1 = x @ params["W1"] + params["b1"]  # sumele ponderate ale celor 128 de neuroni ascunși    h = np.maximum(z1, 0)  # ReLU    logits = h @ params["W2"] + params["b2"]  # 10 scoruri nenormalizate, câte unul pentru fiecare cifră    # Valorile intermediare sunt păstrate pentru retropropagare.    return logits, (x, z1, h)
Ponderile pornesc de la valori aleatoare, cu inițializarea He, potrivită pentru ReLU, iar bias-urile pornesc de la zero. Funcția forward întoarce și valorile intermediare, x, z1 și h, de care retropropagarea va avea nevoie, la fel cum fiecare obiect Value își păstra operanzii.
Softmax și entropia încrucișată
Secțiune intitulată „Softmax și entropia încrucișată”Cele 10 ieșiri sunt scoruri nenormalizate (logits): numere oarecare, pozitive sau negative. Funcția softmax le transformă în probabilități: fiecare scor trece prin funcția exponențială, care face din orice număr unul pozitiv, apoi rezultatele sunt împărțite la suma tuturor rezultatelor, ca să dea 1 împreună. Cifra cu scorul cel mai mare primește cea mai mare probabilitate.
Pierderea este entropia încrucișată (cross-entropy): logaritmul negativ al probabilității date cifrei corecte, mediat pe lot. Dacă rețeaua dă cifrei corecte probabilitatea 1, pierderea este 0. Dacă îi dă o probabilitate mică, pierderea crește foarte repede.
Pentru curioșiSoftmax și entropia încrucișată
Pentru scorurile ale unei imagini, softmax dă probabilitățile:
Pentru un lot de imagini, în care imaginea are eticheta , pierderea este:
def softmax(logits):    # Scădem maximul fiecărui rând: rezultatul este același, dar exp nu mai poate depăși valorile reprezentabile.    e = np.exp(logits - logits.max(axis=1, keepdims=True))    return e / e.sum(axis=1, keepdims=True)

def cross_entropy(probs, y):    # Media logaritmului negativ al probabilității date cifrei corecte.    return -np.log(probs[np.arange(len(y)), y] + 1e-12).mean()
O rețea care nu știe nimic dă fiecărei cifre probabilitatea 1/10, deci pierderea este . Rețeaua noastră, abia inițializată, are pe imaginile de testare pierderea 2,40 și ghicește corect 9,87% din cifre, cam cât ar ghici la întâmplare.
import numpy as npfrom mnist_numpy import softmax, cross_entropy
logits = np.array([  [2.0, 1.0, 0.1],     # scorul cel mai mare pentru clasa 0  [0.0, 0.0, 0.0],     # scoruri egale: probabilități egale  [1000.0, 0.0, 0.0],  # exp(1000) ar depăși valorile reprezentabile fără scăderea maximului])probs = softmax(logits)print(probs.round(4))print("sumele pe rânduri:", probs.sum(axis=1))print()labels = np.array([0, 0, 1])for i in range(3):  print(f"rândul {i}: probabilitatea clasei corecte {probs[i, labels[i]]:.4f}, "        f"pierderea {cross_entropy(probs[i:i + 1], labels[i:i + 1]):.4f}")print()print("10 scoruri egale, pierderea:", cross_entropy(softmax(np.zeros((1, 10))), np.array([3])))print("ln 10 =", np.log(10))
Codul poate fi modificat și rulat direct în browser (Ctrl + Enter).
Pe ultimul rând, rețeaua este foarte sigură pe clasa greșită, iar probabilitatea clasei corecte este practic zero. Constanta 1e-12 din cross_entropy împiedică logaritmul lui zero, așa că pierderea ajunge la , nu la infinit.
Retropropagarea scrisă de mână
Secțiune intitulată „Retropropagarea scrisă de mână”Sistemul pentru scalari aplica regula lanțului nod cu nod. Pentru matrice, aceleași reguli se scriu o singură dată pentru fiecare strat. Pornim de la pierdere și mergem înapoi:
- Pentru softmax urmat de entropie încrucișată, gradientul în raport cu scorurile are o formă foarte simplă: probabilitățile, din care se scade 1 la cifra corectă, împărțite la numărul de imagini din lot. Dacă rețeaua a dat cifrei corecte probabilitatea 0,7, gradientul este −0,3, iar scorul cifrei corecte va fi împins în sus.
- Pentru un strat liniar, gradientul ponderilor este produsul dintre intrările stratului, transpuse, și gradientul ieșirilor stratului. Gradientul bias-ului este suma gradienților ieșirilor pe tot lotul. Gradientul trimis stratului anterior este produsul dintre gradientul ieșirilor și ponderile transpuse.
- ReLU lasă gradientul să treacă doar acolo unde suma ponderată a fost pozitivă, ca în
Value.relu.
Pentru curioșiGradienții rețelei, pentru matrice
Cu , și , notăm cu matricea etichetelor în codificarea one-hot (1 la cifra corectă, 0 în rest) și cu probabilitățile. Atunci:
unde este înmulțirea element cu element, iar este 1 unde suma ponderată a fost pozitivă și 0 în rest. Fiecare formulă este regula lanțului de pe pagina despre diferențierea automată, aplicată tuturor elementelor unei matrice deodată: în , de exemplu, fiecare pondere primește suma, pe tot lotul, a gradientului ieșirii în care intră, înmulțit cu intrarea pe care o înmulțește.
def backward(params, cache, probs, y): x, z1, h = cache n = len(y) # Gradientul pierderii în raport cu scorurile: probabilitățile, minus 1 la cifra corectă, împărțite la lot. dlogits = probs.copy() dlogits[np.arange(n), y] -= 1 dlogits /= n # Stratul de ieșire: logits = h @ W2 + b2. dW2 = h.T @ dlogits db2 = dlogits.sum(axis=0) dh = dlogits @ params["W2"].T # ReLU lasă gradientul să treacă doar unde neuronul a fost activ. dz1 = dh * (z1 > 0) # Stratul ascuns: z1 = x @ W1 + b1. dW1 = x.T @ dz1 db1 = dz1.sum(axis=0) return {"W1": dW1, "b1": db1, "W2": dW2, "b2": db2}Funcția are doar câteva rânduri, dar o greșeală în oricare rând nu ar produce nicio eroare, doar o rețea care învață prost. De aceea, o verificăm cu diferențe finite, pe o rețea mică, cu 6 intrări, 5 neuroni ascunși și 4 ieșiri, în care fiecare parametru poate fi modificat pe rând.
import numpy as npfrom mnist_numpy import init_params, forward, softmax, cross_entropy, backward
# O rețea mică, în precizie dublă, ca diferențele finite să fie exacte.params = {k: v.astype(np.float64) for k, v in init_params(n_in=6, n_hidden=5, n_out=4, seed=1).items()}rng = np.random.default_rng(1)x = rng.random((3, 6))y = np.array([0, 2, 3])
def loss():  logits, _ = forward(params, x)  return cross_entropy(softmax(logits), y)
logits, cache = forward(params, x)grads = backward(params, cache, softmax(logits), y)
eps = 1e-6for name, p in params.items():  numeric = np.zeros_like(p)  for i in np.ndindex(p.shape):      old = p[i]      p[i] = old + eps      up = loss()      p[i] = old - eps      down = loss()      p[i] = old      numeric[i] = (up - down) / (2 * eps)  print(f"{name}: forma {p.shape}, diferența maximă {np.abs(grads[name] - numeric).max():.1e}")
Codul poate fi modificat și rulat direct în browser (Ctrl + Enter).
Diferențele sunt de ordinul sau mai mici, cât permite precizia calculului numeric. Gradienții scriși de mână sunt corecți.
Antrenarea
Secțiune intitulată „Antrenarea”Antrenarea folosește coborârea pe gradient stocastică (stochastic gradient descent, SGD). Gradientul nu se calculează pe toate cele 60.000 de imagini odată, ci pe loturi (batches) mici, de câte 64 de imagini, alese în ordine aleatoare. Fiecare lot dă o estimare puțin zgomotoasă a gradientului, dar parametrii se actualizează de 938 de ori la fiecare trecere prin setul de antrenare, numită epocă (epoch), nu o singură dată.
def predict(params, x):    logits, _ = forward(params, x)    return logits.argmax(axis=1)

def train(params, x_train, y_train, x_test, y_test, epochs=10, batch_size=64, lr=0.1, seed=0):    rng = np.random.default_rng(seed)    for epoch in range(1, epochs + 1):        start = time.time()        # La fiecare epocă, imaginile sunt amestecate și împărțite în loturi de câte 64.        order = rng.permutation(len(x_train))        total_loss = 0.0        for i in range(0, len(order), batch_size):            idx = order[i : i + batch_size]            x, y = x_train[idx], y_train[idx]            logits, cache = forward(params, x)            probs = softmax(logits)            total_loss += cross_entropy(probs, y) * len(y)            grads = backward(params, cache, probs, y)            for name in params:                params[name] -= lr * grads[name]        test_acc = (predict(params, x_test) == y_test).mean()        print(            f"epoca {epoch:2d}   pierdere {total_loss / len(x_train):.4f}   "            f"acuratețe la testare {test_acc:.2%}   {time.time() - start:.1f} s"        )    return params
Pașii sunt aceiași ca pentru rețeaua mică: propagarea directă, pierderea, retropropagarea și actualizarea params[name] -= lr * grads[name]. Gradienții nu trebuie readuși la zero, pentru că backward îi calculează de fiecare dată de la început. După fiecare epocă, codul măsoară acuratețea pe cele 10.000 de imagini de testare, pe care rețeaua nu le vede niciodată la antrenare.
Pe calculatorul local, antrenarea se pornește cu o singură comandă.
python mnist_numpy.pyPe un laptop modern, fiecare epocă a durat 0,2–0,3 secunde, iar toate cele 10 epoci, 2,2 secunde. Rezultatul arată astfel.
Imagini de antrenare: 60000, de testare: 10000, parametri: 101,770epoca 1 pierdere 0.3617 acuratețe la testare 93.99% 0.2 sepoca 2 pierdere 0.1899 acuratețe la testare 94.99% 0.2 sepoca 3 pierdere 0.1436 acuratețe la testare 96.36% 0.3 sepoca 4 pierdere 0.1172 acuratețe la testare 96.58% 0.3 sepoca 5 pierdere 0.0988 acuratețe la testare 97.19% 0.2 sepoca 6 pierdere 0.0858 acuratețe la testare 97.29% 0.2 sepoca 7 pierdere 0.0756 acuratețe la testare 97.33% 0.2 sepoca 8 pierdere 0.0678 acuratețe la testare 97.47% 0.2 sepoca 9 pierdere 0.0610 acuratețe la testare 97.57% 0.2 sepoca 10 pierdere 0.0552 acuratețe la testare 97.62% 0.2 sDurata antrenării: 2.2 sImagini de testare clasificate greșit: 238 din 10000 3 citit ca 5: de 15 ori 2 citit ca 8: de 11 ori 4 citit ca 9: de 11 ori 9 citit ca 4: de 11 ori 7 citit ca 2: de 10 oriExemplele au fost salvate în imagini/predictii.png și imagini/greseli.pngPierderea medie din prima epocă, 0,36, este deja mult sub 2,30, pentru că rețeaua învață chiar din primele loturi. După 10 epoci, rețeaua recunoaște corect 97,62% din cifrele de testare, adică greșește 238 din 10.000. Datorită semințelor fixe, pierderile și acuratețile sunt aceleași la fiecare rulare, pe același calculator. Durata variază de la o rulare la alta, iar pe calculatoarele mai vechi sau în Google Colab poate fi de câteva ori mai mare, dar rămâne de ordinul secundelor.
Imaginea de mai jos arată primele 12 cifre din setul de testare, cu cifra prezisă de rețea deasupra fiecăreia. Toate sunt clasificate corect.
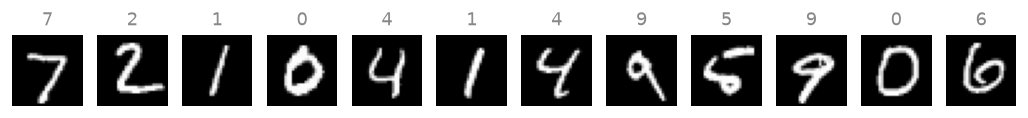
Mai interesante sunt greșelile. Imaginea următoare arată primele 12 cifre de testare clasificate greșit, cu cifra prezisă și, între paranteze, cifra corectă.
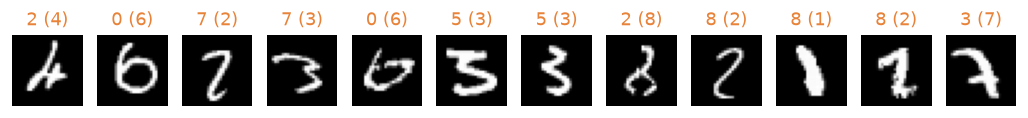
Unele greșeli sunt de înțeles, pentru că cifrele sunt scrise neobișnuit, iar altele, ca 6-urile citite ca 0, arată limitele rețelei, care vede doar 784 de numere separate, fără să știe care pixeli sunt vecini. Rețelele convoluționale, construite pentru imagini, folosesc tocmai această vecinătate și ajung la peste 99% pe MNIST.
Aceeași rețea în PyTorch
Secțiune intitulată „Aceeași rețea în PyTorch”În PyTorch, rețeaua se scrie din straturi gata făcute. nn.Linear este stratul cu ponderi și bias, iar nn.ReLU, activarea.
def make_model():    return nn.Sequential(nn.Linear(784, 128), nn.ReLU(), nn.Linear(128, 10))

def train(x_train, y_train, x_test, y_test, epochs=10, batch_size=64, lr=0.1, seed=0):    torch.manual_seed(seed)    model = make_model()    optimizer = torch.optim.SGD(model.parameters(), lr=lr)
    for epoch in range(1, epochs + 1):        start = time.time()        order = torch.randperm(len(x_train))        total_loss = 0.0        for i in range(0, len(order), batch_size):            idx = order[i : i + batch_size]            loss = nn.functional.cross_entropy(model(x_train[idx]), y_train[idx])  # softmax inclus            optimizer.zero_grad()  # gradienții pasului anterior se șterg            loss.backward()  # retropropagarea, făcută de autograd            optimizer.step()  # p -= lr * p.grad, pentru fiecare parametru            total_loss += loss.item() * len(idx)        with torch.no_grad():            test_acc = (model(x_test).argmax(dim=1) == y_test).float().mean().item()        print(            f"epoca {epoch:2d}   pierdere {total_loss / len(x_train):.4f}   "            f"acuratețe la testare {test_acc:.2%}   {time.time() - start:.1f} s"        )    return model
Nu mai scriem nici backward, nici softmax. Funcția cross_entropy primește direct scorurile nenormalizate și aplică singură softmax, loss.backward() face retropropagarea cu autograd, iar optimizer.step() face actualizarea p -= lr * p.grad pentru fiecare parametru. optimizer.zero_grad() are același rol ca zero_grad() din nn.py: gradienții se adună și aici de la un backward() la altul.
Înainte de antrenare, scriptul verifică retropropagarea noastră încă o dată: copiază aceleași ponderi în rețeaua PyTorch, calculează gradienții pe același lot de 64 de imagini în ambele feluri și îi compară.
def compare_gradients(x, y):    # Aceleași ponderi în NumPy și în PyTorch, apoi gradienții calculați de mână și de autograd, pe același lot.    params = init_params()    logits, cache = forward(params, x)    ours = backward(params, cache, softmax(logits), y)
    model = make_model()    with torch.no_grad():        # nn.Linear ține ponderile transpuse: forma (ieșiri, intrări).        model[0].weight.copy_(torch.from_numpy(params["W1"].T))        model[0].bias.copy_(torch.from_numpy(params["b1"]))        model[2].weight.copy_(torch.from_numpy(params["W2"].T))        model[2].bias.copy_(torch.from_numpy(params["b2"]))    loss = nn.functional.cross_entropy(model(torch.from_numpy(x)), torch.from_numpy(y))    loss.backward()
    theirs = {        "W1": model[0].weight.grad.T,        "b1": model[0].bias.grad,        "W2": model[2].weight.grad.T,        "b2": model[2].bias.grad,    }    for name in ours:        diff = np.abs(ours[name] - theirs[name].numpy()).max()        print(f"  {name}: diferența maximă {diff:.1e}")
PyTorch nu face parte din requirements.txt, pentru că are câteva sute de megaocteți. Pentru a-l instala și a rula scriptul, folosiți comenzile de mai jos.
pip install torchpython mnist_torch.pyRezultatul arată astfel.
Gradienții NumPy față de autograd, pe un lot de 64 de imagini:  W1: diferența maximă 5.6e-09  b1: diferența maximă 1.5e-08  W2: diferența maximă 1.5e-08  b2: diferența maximă 3.0e-08
epoca  1   pierdere 0.4382   acuratețe la testare 92.70%   0.5 sepoca  2   pierdere 0.2264   acuratețe la testare 94.38%   0.4 sepoca  3   pierdere 0.1695   acuratețe la testare 95.72%   0.4 sepoca  4   pierdere 0.1353   acuratețe la testare 96.05%   0.4 sepoca  5   pierdere 0.1127   acuratețe la testare 96.76%   0.3 sepoca  6   pierdere 0.0961   acuratețe la testare 97.02%   0.4 sepoca  7   pierdere 0.0837   acuratețe la testare 97.23%   0.4 sepoca  8   pierdere 0.0745   acuratețe la testare 97.27%   0.4 sepoca  9   pierdere 0.0662   acuratețe la testare 97.55%   0.4 sepoca 10   pierdere 0.0597   acuratețe la testare 97.57%   0.4 sDurata antrenării: 4.3 s
Gradienții calculați de mână și cei calculați de PyTorch diferă cu cel mult , cât permit numerele zecimale de 32 de biți. Antrenarea ajunge la 97,57%, aproape cât varianta NumPy. Diferențele mici vin din punctul de pornire: nn.Linear își inițializează ponderile cu altă distribuție decât inițializarea He din init_params, iar loturile sunt amestecate de alt generator de numere aleatoare.
Același cod rulează și pe o placă grafică, după ce rețeaua și datele sunt mutate pe placă cu .to("cuda") sau .to("mps"). Pentru o rețea atât de mică, procesorul este însă suficient. Laboratorul Un model de limbaj de la zero continuă de aici, cu un Transformer de 14,6 milioane de parametri, scris tot în PyTorch.
Bibliografie
Secțiune intitulată „Bibliografie”- Harris, C. R. et al. (2020). Array programming with NumPy. Nature, 585(7825), 357–362.
- He, K. et al. (2015). Delving Deep into Rectifiers: Surpassing Human-Level Performance on ImageNet Classification. ICCV 2015.
- LeCun, Y. et al. (1998). Gradient-based learning applied to document recognition. Proceedings of the IEEE, 86(11), 2278–2324. ↩︎
- Paszke, A. et al. (2019). PyTorch: An Imperative Style, High-Performance Deep Learning Library. NeurIPS 2019.
- Rumelhart, D. E., Hinton, G. E. și Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323(6088), 533–536.
Cookie-uri
Site-ul folosește Google Analytics pentru statistici de trafic. Cookie-urile de analiză se activează doar după acceptare. Detalii în politica de cookie-uri.